Si el servidor de tu ERP está lento, aumentar la RAM o cambiarlo por uno más potente puede parecer la solución más rápida. El problema es que un servidor lento no necesariamente tiene un problema de hardware.
La lentitud puede estar relacionada con el procesador, la memoria, el almacenamiento, SQL Server, las conexiones de los usuarios, bloqueos o incluso con la red. Por eso, antes de cotizar otro servidor conviene identificar qué recurso está limitando realmente el funcionamiento del ERP.
¿Qué significa realmente que el servidor del ERP esté lento?
“El servidor está lento” puede describir situaciones muy diferentes. Antes de revisar componentes, conviene relacionar el síntoma con el alcance del problema.
| Lo que ocurre | Qué conviene investigar |
|---|---|
| Todos los usuarios perciben lentitud | Servidor, SQL Server, almacenamiento, memoria o procesos simultáneos |
| Solo una computadora está lenta | Estación de trabajo, red local o configuración del equipo |
| Solo una operación tarda demasiado | Consulta, proceso específico o bloqueo en la base de datos |
| La lentitud aparece en determinados horarios | Respaldos, procesos programados, mayor concurrencia o cargas simultáneas |
| El ERP se desconecta además de estar lento | Conectividad, red, servicios o comunicación con el servidor |
Microsoft contempla como áreas relevantes para localizar cuellos de botella la memoria, el procesador, las operaciones de entrada y salida de disco, las conexiones de usuarios y los bloqueos. También señala que una causa puede ser la falta de recursos, una distribución desigual de la carga o una configuración inadecuada.
Consulta la guía de Microsoft para identificar cuellos de botella en SQL Server.
Sigue la pista del cuello de botella
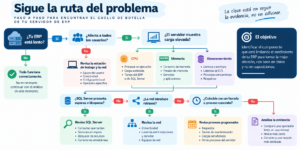
Antes de cambiar hardware, sigue una secuencia sencilla. La primera pregunta no es “¿cuánta RAM necesito?”, sino ¿dónde empieza la lentitud?.
- ¿El ERP está lento?
- No: no hay un problema de rendimiento que diagnosticar en ese momento.
- Sí: continúa con la siguiente pregunta.
- ¿Afecta a todos los usuarios?
- No: compara la estación afectada con una que funcione normalmente y revisa red, equipo y operación.
- Sí: continúa revisando el servidor y los servicios compartidos.
- ¿El servidor muestra carga elevada mientras ocurre?
- CPU: revisa procesos y carga de trabajo.
- Memoria: revisa presión de memoria y consumo.
- Almacenamiento: observa las operaciones de entrada y salida y sus tiempos de respuesta.
- Ninguno destaca: continúa con SQL Server y la red.
- ¿SQL Server presenta esperas o bloqueos?
- Sí: investiga consultas, sesiones y recursos que estén esperando.
- No: continúa con la revisión de conectividad y procesos concurrentes.
- ¿La red introduce retrasos?
- Sí: revisa conectividad entre estaciones y servidor.
- No: continúa con la siguiente comprobación.
- ¿La lentitud coincide con un horario o proceso concreto?
- Sí: identifica qué tarea se ejecuta en ese momento.
- No: conserva las mediciones y compara el comportamiento durante una operación lenta y otra normal.
Nuestro objetivo no es señalar automáticamente un componente como culpable, Es reducir el campo de búsqueda hasta encontrar qué recurso o proceso merece una revisión más detallada.
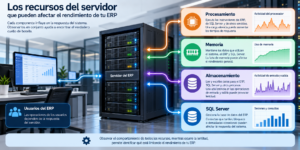
CPU: ¿el procesador realmente está limitando al ERP?
Un porcentaje elevado de CPU puede llamar inmediatamente la atención, pero ver el procesador ocupado no basta para concluir que hay que cambiarlo.
Lo importante es observar qué ocurre durante la operación lenta: qué procesos consumen CPU, si el comportamiento se mantiene durante el incidente y si la carga coincide con una tarea concreta del ERP o de SQL Server.
Microsoft señala que un uso de CPU elevado y sostenido puede estar relacionado con consultas que requieren optimización o con una capacidad de procesamiento insuficiente, por lo que conviene identificar primero qué está generando la carga.
RAM: ¿la memoria está provocando la lentitud?
La falta de memoria puede afectar el rendimiento porque obliga al sistema y a las aplicaciones a gestionar los datos con mayor presión sobre otros recursos, especialmente cuando la carga de trabajo aumenta.
Por eso, no conviene decidir la cantidad de RAM únicamente por el número de usuarios. Hay que observar el consumo real mientras se ejecutan las operaciones que generan problemas y considerar qué otros servicios comparten el servidor.
Consulta la documentación de Microsoft sobre problemas de memoria en SQL Server.
Almacenamiento: cuando el problema está en las operaciones de entrada y salida
El almacenamiento puede convertirse en un cuello de botella cuando el servidor necesita leer o escribir datos y las operaciones de entrada y salida presentan tiempos de respuesta elevados.
En este caso, observar únicamente el porcentaje de utilización del disco puede llevar a conclusiones equivocadas. Es más útil relacionar la actividad de almacenamiento con el momento exacto en que el ERP se vuelve lento.
Si el problema aparece únicamente cuando se ejecutan determinados procesos, conviene comprobar qué actividad está generando esas operaciones y cuánto tarda en responder el almacenamiento.
¿Y si el problema está en SQL Server?
Cuando CPU, memoria y almacenamiento no explican por sí solos la lentitud, SQL Server merece una revisión específica.
Una consulta puede tardar porque está esperando un recurso, porque otra operación mantiene ocupado un recurso necesario o porque existe una carga simultánea que reduce la capacidad de respuesta.
Los bloqueos son especialmente importantes: una operación que espera a otra puede hacer que los usuarios perciban el ERP como lento aunque el servidor no esté utilizando al máximo todos sus recursos.
Por eso, cuando el problema coincide con determinadas operaciones, conviene investigar qué consultas, sesiones o recursos están involucrados antes de asumir que falta potencia en el servidor.
¿Qué recurso parece estar limitando al servidor?
| Indicador observado | Qué investigar primero | Qué evitar concluir demasiado pronto |
|---|---|---|
| CPU elevada durante la operación lenta | Procesos, consultas y carga simultánea | Que necesariamente hace falta un procesador nuevo |
| Presión de memoria | Consumo de SQL Server, sistema y otras aplicaciones | Que cualquier ampliación de RAM resolverá el problema |
| Respuesta lenta de almacenamiento | Operaciones de entrada y salida y actividad coincidente | Que el problema sea simplemente “el disco lleno” |
| Esperas o bloqueos en SQL Server | Consultas, sesiones y recursos involucrados | Que el servidor completo tenga poca capacidad |
| Problemas solo en determinados usuarios | Estación de trabajo y conectividad | Que sea necesario reemplazar el servidor |
| Lentitud en horarios concretos | Procesos programados y concurrencia | Que el hardware sea insuficiente todo el tiempo |
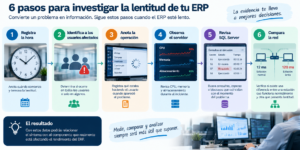
Haz una prueba de seis pasos antes de cambiar componentes
Cuando aparezca la lentitud, documenta el incidente en lugar de intentar reproducirlo únicamente de memoria. Una prueba sencilla permite relacionar lo que percibe el usuario con lo que ocurre en la infraestructura.
- Registra la hora: anota cuándo comienza y termina la lentitud.
- Identifica a los usuarios afectados: determina si ocurre en todos los equipos o solo en algunos.
- Anota la operación: registra qué estaba haciendo el usuario cuando apareció el problema.
- Observa el servidor: revisa CPU, memoria y actividad de almacenamiento durante el incidente.
- Revisa SQL Server: busca consultas, esperas o bloqueos que coincidan con el momento del problema.
- Compara la red: comprueba si existe una diferencia entre una estación que funciona normalmente y otra que presenta lentitud.
La recopilación de datos es importante porque una medición aislada puede representar solo un pico momentáneo. La guía de Microsoft para solucionar problemas de rendimiento en Windows utiliza precisamente el análisis de componentes como procesador, memoria, almacenamiento y red para acotar el origen del problema.
Consulta la guía de Microsoft para solucionar problemas de rendimiento en Windows Server.
Compara una operación lenta con una operación normal
Una de las comprobaciones más útiles consiste en comparar dos situaciones: una en la que el ERP responde correctamente y otra en la que tarda demasiado.
| Qué comparar | Durante una respuesta normal | Durante la lentitud |
|---|---|---|
| Usuarios conectados | Quiénes están trabajando | Quiénes están trabajando |
| Operación | Qué proceso se ejecuta | Qué proceso se ejecuta |
| CPU | Carga observada | Carga observada |
| Memoria | Consumo observado | Consumo observado |
| Almacenamiento | Actividad y respuesta | Actividad y respuesta |
| SQL Server | Consultas y esperas relevantes | Consultas y esperas relevantes |
| Red | Comportamiento de la conexión | Comportamiento de la conexión |
La diferencia entre ambos momentos puede ser más útil que una medición aislada del servidor. Si los recursos permanecen similares pero una operación concreta se vuelve lenta, la investigación debería dirigirse hacia esa operación y no automáticamente hacia el hardware.
¿Cuándo sí tiene sentido mejorar el servidor?
Una ampliación de infraestructura puede tener sentido cuando las mediciones muestran que un recurso se encuentra realmente limitado durante la carga habitual del ERP y esa limitación coincide con la pérdida de rendimiento.
Por ejemplo, puede ser razonable evaluar una ampliación cuando:
- la memoria disponible resulta insuficiente para la carga habitual;
- el procesador permanece bajo una carga elevada asociada a los procesos del ERP;
- el almacenamiento presenta una respuesta insuficiente durante operaciones intensivas;
- la carga de usuarios y servicios ha aumentado respecto al entorno original;
- el servidor ahora ejecuta procesos adicionales que antes no tenía;
- las mediciones muestran que el recurso limitado es recurrente y no un evento aislado.
Si quieres profundizar en este escenario, puedes consultar también qué hacer cuando un ERP se cae por falta de recursos del servidor.
¿Cuándo cambiar el servidor probablemente no solucionará el problema?
Cambiar el hardware puede ser una decisión poco útil cuando la causa está fuera de los componentes que se pretende sustituir.
Antes de invertir, conviene detenerse especialmente si:
- solo una computadora presenta el problema;
- la lentitud aparece únicamente con una operación determinada;
- el servidor mantiene recursos disponibles durante el incidente;
- existen bloqueos o esperas en SQL Server;
- la lentitud coincide con un proceso programado;
- el problema comenzó después de un cambio de configuración, red o software;
- la dificultad principal es de conectividad y no de procesamiento.
En esos casos, un servidor más potente puede ocultar temporalmente el síntoma sin resolver la causa original.
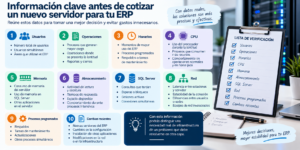
¿Qué información debes reunir antes de cotizar otro servidor?
Si después del diagnóstico sí parece necesario modificar la infraestructura, reúne primero información suficiente para que la propuesta tenga una base técnica.
| Información | Qué registrar |
|---|---|
| Usuarios | Número de usuarios y cuántos trabajan simultáneamente |
| Operaciones | Procesos que generan mayor carga o lentitud |
| Horarios | Momentos en que se concentra el trabajo |
| CPU | Comportamiento durante las operaciones problemáticas |
| Memoria | Consumo del servidor y de SQL Server |
| Almacenamiento | Actividad y tiempos de respuesta durante la lentitud |
| SQL Server | Consultas, esperas o bloqueos detectados |
| Red | Comportamiento de las estaciones afectadas |
| Procesos programados | Respaldos, tareas de mantenimiento u otras cargas simultáneas |
| Cambios recientes | Modificaciones de software, red, configuración o infraestructura |
Con estos datos es mucho más sencillo distinguir una necesidad real de infraestructura de un problema que debe resolverse en otra capa.
¿Un VPS o un servidor nuevo siempre es la solución?
No necesariamente. Un VPS, un servidor físico o una ampliación del entorno actual son alternativas que deben evaluarse después de identificar el recurso que está limitando el rendimiento.
Si el problema está en una consulta, un bloqueo, una conexión o un proceso programado, cambiar de infraestructura no ataca directamente esa causa.
En cambio, si las mediciones muestran una limitación sostenida de recursos y la carga de trabajo ya supera la capacidad disponible, entonces sí tiene sentido estudiar una ampliación, migración o rediseño de la infraestructura.
Una revisión ordenada evita cambiar hardware a ciegas
La lentitud del servidor de un ERP debe investigarse como un problema de rendimiento, no únicamente como una falta de potencia.
Primero identifica cuándo ocurre, a quién afecta y qué operación la provoca. Después relaciona ese síntoma con CPU, memoria, almacenamiento, SQL Server y red. Finalmente, utiliza las mediciones para decidir si hace falta corregir una configuración, optimizar un proceso o modificar la infraestructura.
Si después de este diagnóstico necesitas revisar la infraestructura disponible o plantear una nueva arquitectura para el ERP, Cobalt Blue Web puede ayudarte a evaluar el entorno con base en las necesidades reales de operación. También puedes encontrar más contenidos prácticos en el blog de ERP Nube México.
La pregunta correcta no es solamente qué servidor necesita tu ERP, sino qué está haciendo que funcione lento y qué evidencia tienes para corregirlo.
Cuando Aspel SAE empieza a tardar, el problema no siempre está en el servidor. Una factura que tarda en abrir, una consulta que se queda pensando o un proceso que funciona bien por la mañana y se vuelve pesado más tarde pueden estar señalando problemas diferentes.
En SAE hay además elementos de la instalación que conviene revisar antes de pensar en cambiar hardware, especialmente cuando el sistema trabaja con varias estaciones y recursos compartidos.
La forma más práctica de encontrar el origen es observar qué operación se vuelve lenta, cómo se comporta desde diferentes equipos y qué ocurre en el entorno de SAE mientras sucede.
Empieza identificando qué cambió
La primera pista suele estar en la comparación entre el funcionamiento habitual y el momento en que apareció la lentitud.
Pregúntate:
- ¿SAE siempre ha funcionado así o empezó a tardar recientemente?
- ¿La lentitud apareció después de agregar usuarios o estaciones?
- ¿Coincidió con algún cambio en el servidor o en la red?
- ¿El problema aparece después de determinado tiempo de trabajo?
- ¿La espera ocurre al abrir SAE, consultar información, guardar datos o ejecutar un proceso concreto?
Estas respuestas ayudan a separar un problema que apareció después de un cambio de uno relacionado con el crecimiento o la carga habitual de la operación.
Cuando solo una operación se vuelve lenta
Si la mayoría de las funciones responden con normalidad y únicamente una operación tarda demasiado, conviene estudiar primero qué sucede durante esa tarea.
Por ejemplo, si consultar determinada información es lento pero navegar por otras partes de SAE continúa siendo fluido, aumentar la capacidad general del servidor puede no resolver el origen.
En este escenario interesa observar:
- Qué información está consultando la operación.
- Cuánto tarda en completarse.
- Si el comportamiento se repite siempre.
- Si otros usuarios experimentan la misma espera.
- Qué actividad presenta SQL Server mientras se ejecuta.
El análisis de rendimiento de SQL Server contempla diferentes capas, entre ellas la aplicación, CPU, memoria, E/S, red y bloqueos. Consulta la guía de Microsoft para investigar problemas de rendimiento de SQL Server.
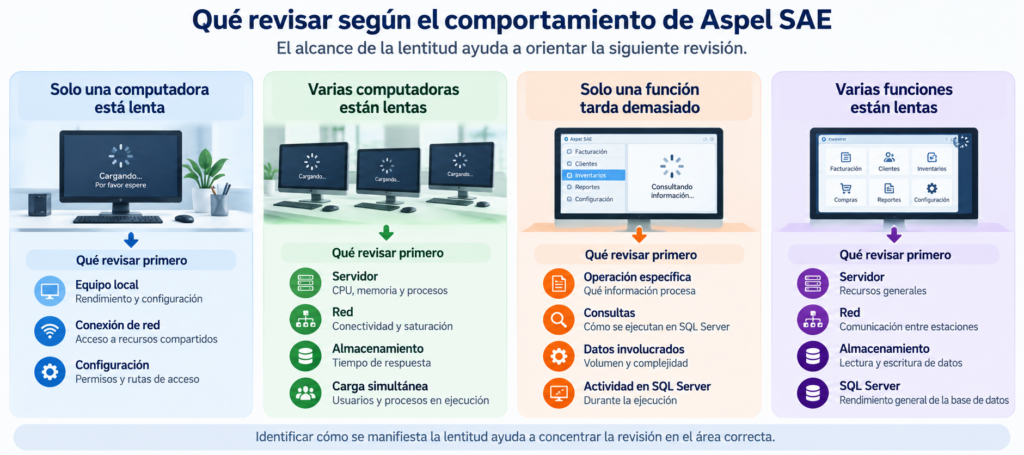
Cuando todo SAE empieza a responder despacio
El escenario cambia cuando la lentitud aparece en varias funciones y afecta a diferentes usuarios.
Ahí conviene observar el entorno completo mientras ocurre el problema:
| Lo que ocurre | Qué conviene observar |
|---|---|
| Varias estaciones se vuelven lentas al mismo tiempo | Servidor, red, almacenamiento, SQL Server y carga simultánea. |
| La lentitud aparece en determinados horarios | Usuarios conectados, procesos adicionales y carga acumulada. |
| El servidor muestra actividad elevada durante la incidencia | CPU, memoria, almacenamiento y procesos que están utilizando recursos. |
| Los usuarios pierden respuesta mientras trabajan | Conectividad, recursos compartidos y comportamiento de la aplicación. |
La guía de Microsoft para identificar cuellos de botella también considera recursos como CPU, memoria, almacenamiento, conexiones y bloqueos al investigar problemas de rendimiento. Revisa la documentación de Microsoft sobre identificación de cuellos de botella.
Hay una diferencia importante entre lentitud y falta de conexión
Una aplicación lenta y una aplicación que pierde conexión pueden producir sensaciones parecidas para el usuario, pero requieren comprobaciones diferentes.
Si SAE permanece abierto y finalmente completa una operación, estamos ante un comportamiento distinto al de una estación que deja de comunicarse con el servidor.
Por eso conviene registrar exactamente qué observa el usuario:
- La pantalla tarda, pero finalmente responde.
- Una operación concreta tarda mucho más que las demás.
- SAE deja de responder temporalmente.
- La estación pierde acceso a un recurso compartido.
- La aplicación muestra un error relacionado con la conexión.
La diferencia evita investigar exclusivamente el hardware cuando el problema puede estar en comunicación, configuración o en una operación específica.
El Directorio de Archivos Comunes merece una revisión propia
En una instalación de Aspel SAE que trabaja en red aparece un elemento que no conviene tratar como un detalle secundario: el Directorio de Archivos Comunes (DAC).
El trabajo en red de SAE utiliza recursos compartidos y el DAC forma parte de la configuración del entorno. Aspel documenta este esquema y la ubicación del directorio común. Consulta la documentación oficial de Aspel sobre trabajo en red con SAE.
Por eso, si el comportamiento de SAE cambió después de modificar el servidor, mover recursos, cambiar estaciones o alterar la configuración de red, conviene comprobar que los equipos puedan acceder correctamente a los recursos que utiliza la instalación.
Esta comprobación es especialmente útil porque permite investigar una parte concreta del entorno de SAE sin asumir desde el principio que el servidor necesita más capacidad.

Compara una misma operación desde dos computadoras
Una comparación sencilla puede revelar diferencias que no aparecen cuando se observa únicamente el servidor.

Elige una operación que los usuarios identifiquen claramente como lenta y ejecútala desde dos estaciones que trabajen con la misma instalación.
- Realiza la operación desde la computadora donde el problema sea evidente.
- Registra aproximadamente cuánto tarda.
- Repite la misma operación desde otra estación.
- Comprueba si ambas computadoras utilizan la misma ubicación y recursos.
- Observa el comportamiento del servidor durante ambas ejecuciones.
- Compara las diferencias entre los resultados.
Si una estación presenta un comportamiento claramente distinto de otra, conviene revisar primero aquello que cambia entre ambos equipos antes de modificar la infraestructura compartida.
Lo que la comparación puede revelar
| Resultado | Primera línea de investigación |
|---|---|
| Una computadora tarda y otra responde normalmente | Estación afectada, conexión, configuración y acceso a recursos compartidos. |
| Las dos computadoras tardan de forma similar | Elementos compartidos como servidor, red, almacenamiento o base de datos. |
| Solo una función tarda | La operación concreta y lo que sucede durante su ejecución. |
| Varias funciones tardan | Recursos generales y componentes compartidos del entorno. |
La utilidad de esta comparación está en encontrar qué cambia entre los escenarios. Esa diferencia puede ser más reveladora que una revisión aislada de las características del servidor.
Revisa el servidor mientras ocurre la lentitud
Una fotografía de los recursos tomada cuando SAE funciona correctamente dice poco sobre lo que ocurre durante una incidencia.
Cuando vuelva a aparecer el problema, observa:
- CPU: si algún proceso está utilizando una cantidad elevada de procesamiento.
- Memoria: si existe presión sobre la memoria disponible y qué procesos la consumen.
- Almacenamiento: si las operaciones de lectura y escritura presentan tiempos de respuesta elevados.
- SQL Server: qué actividad coincide con la operación que está tardando.
- Red: si las estaciones mantienen una comunicación estable con los recursos que necesitan.
- Carga simultánea: cuántos usuarios están trabajando cuando aparece el problema.
La relación temporal es importante: si un recurso cambia precisamente cuando los usuarios experimentan la espera, tienes una pista mucho más útil para continuar la investigación.
Cuatro situaciones que cambian la investigación
SAE se vuelve lento después de agregar usuarios
El crecimiento de usuarios puede aumentar la actividad simultánea sobre el servidor, la base de datos y la red.
En este caso conviene comparar el comportamiento actual con el que tenía la instalación antes del crecimiento y observar qué recursos se acercan a sus límites durante los periodos de mayor actividad.
La lentitud apareció después de cambiar el servidor
No conviene asumir que el nuevo servidor es automáticamente responsable o que simplemente necesita más capacidad.
Revisa también configuración, almacenamiento, acceso de las estaciones, recursos compartidos y los componentes que cambiaron durante la migración.
El problema apareció después de modificar la red
Si la lentitud comenzó después de cambiar equipos de red, direccionamiento, recursos compartidos o conectividad, la revisión debe incluir esos cambios.
Una instalación puede tener suficiente capacidad de procesamiento y, aun así, presentar tiempos de respuesta deficientes si la comunicación entre las estaciones y el servidor no funciona como debería.
El problema aparece únicamente en determinados horarios
Este patrón apunta a una condición que cambia con la carga.
Registra cuántos usuarios están conectados, qué procesos adicionales se ejecutan y qué actividad presenta el servidor durante ese periodo. Comparar ese momento con un horario de baja actividad puede aportar una pista importante.
Qué revisar antes de pensar en comprar hardware
Antes de solicitar una cotización de servidor, reúne evidencia de los puntos anteriores.
- Qué operaciones presentan lentitud.
- Desde qué estaciones ocurre.
- Cuántos usuarios están conectados.
- En qué horarios aparece.
- Qué recursos del servidor cambian durante la incidencia.
- Cómo están configurados los recursos compartidos.
- Dónde se encuentra el Directorio de Archivos Comunes.
- Qué cambios se realizaron antes de que comenzara el problema.
- Qué comportamiento presenta SQL Server durante las operaciones afectadas.
Con estos datos puedes diferenciar una limitación de infraestructura de un problema localizado en una estación, una conexión, una configuración o una operación concreta.

Cuando la infraestructura realmente se queda corta
Si las observaciones muestran de forma repetida que un recurso del servidor limita la operación durante los periodos de mayor actividad, entonces sí vale la pena evaluar una ampliación o sustitución.
La actualización debe estar relacionada con lo que se encontró. Por ejemplo, una incidencia asociada al almacenamiento requiere una evaluación diferente de una situación en la que el procesamiento se encuentra constantemente limitado.
El objetivo no es comprar capacidad por anticipado, sino relacionar el cambio de infraestructura con una necesidad comprobada.
Qué puede aportar una evaluación de infraestructura
Cuando ya se tienen registros de usuarios, estaciones, operaciones, horarios, recursos y problemas observados, una evaluación técnica puede determinar qué parte del entorno necesita atención.
En ese punto, Cobalt Blue Web puede ayudar a revisar la infraestructura involucrada en la operación de SAE y orientar los cambios a partir de la evidencia recopilada.
Antes de migrar SAE, documenta el entorno actual
Una migración no debería comenzar únicamente con la elección de un servidor nuevo.
Primero documenta cómo funciona actualmente la instalación:
| Elemento | Información que conviene conservar |
|---|---|
| Usuarios | Número de usuarios y forma en que utilizan SAE. |
| Estaciones | Computadoras que acceden a la instalación. |
| Red | Cómo se conectan las estaciones con los recursos compartidos. |
| DAC | Ubicación y configuración del Directorio de Archivos Comunes. |
| Servidor | Recursos disponibles y aplicaciones que ejecuta. |
| SQL Server | Versión, configuración y comportamiento durante las incidencias. |
| Incidencias | Operaciones afectadas, horarios y comportamiento observado. |
Esta información permite que cualquier cambio posterior tenga un punto de comparación y facilita comprobar si el nuevo entorno realmente atiende el problema detectado.
Una revisión ordenada evita cambiar componentes a ciegas
Cuando Aspel SAE está lento, el camino más útil consiste en relacionar el síntoma con lo que ocurre alrededor de él.
Primero identifica qué operación está afectada. Después observa si el comportamiento cambia entre estaciones, revisa el DAC y los recursos compartidos cuando corresponda, y finalmente analiza el servidor mientras la incidencia está ocurriendo.
Si la evidencia apunta a un recurso concreto, la decisión de actualizar infraestructura puede hacerse con un objetivo definido. Si el problema aparece en otra capa, habrás evitado invertir en hardware sin resolver la causa.
Conclusión
La lentitud de Aspel SAE no debería analizarse únicamente mirando las características del servidor. La operación, las estaciones, la red, los recursos compartidos, el Directorio de Archivos Comunes y SQL Server forman parte del entorno que determina cómo responde el sistema.
Observar el comportamiento real de SAE y comparar lo que sucede en diferentes condiciones permite pasar de una percepción de “SAE está lento” a una investigación concreta sobre dónde se produce la espera y qué debe revisarse después.