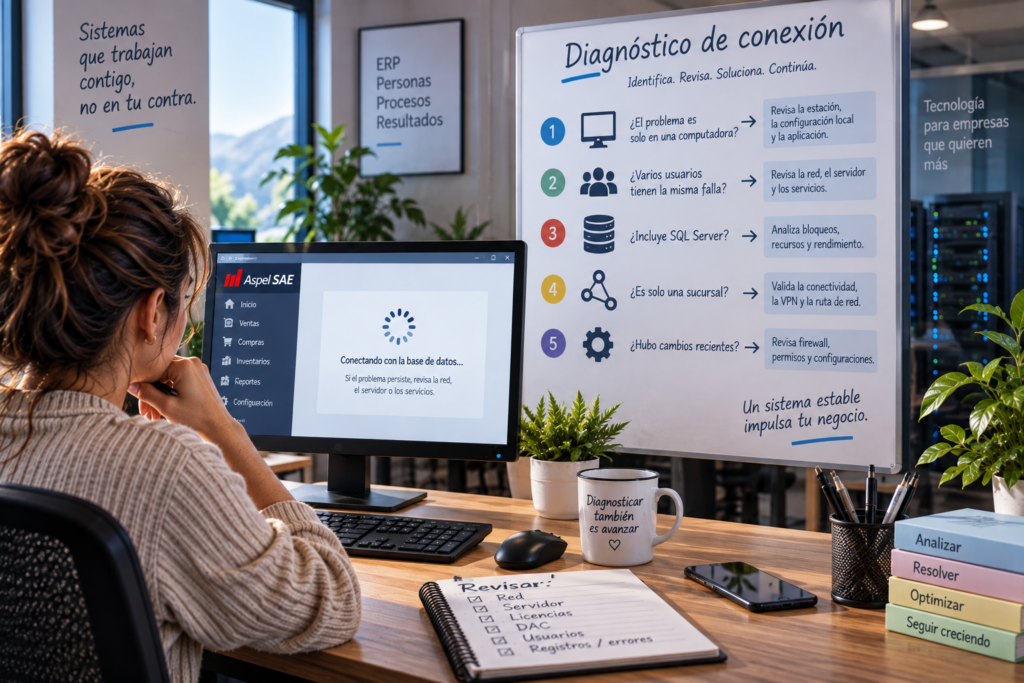
Aspel SAE se bloquea o pierde conexión: cómo diagnosticar la causa
Actualizado el 16 de septiembre de 2026 · Guía para empresas en México
Si Aspel SAE se queda congelado, deja de responder o pierde la conexión mientras los usuarios están trabajando, reiniciar el equipo puede recuperar temporalmente la operación, pero no explica por qué ocurrió.
El origen puede estar en la estación de trabajo, la red, SQL Server, el firewall, el servicio de licencias, el Directorio de Archivos Comunes o algún recurso del servidor. Por eso, antes de cambiar infraestructura, conviene determinar qué falla, a quién afecta y bajo qué condiciones aparece.
El diagnóstico cambia mucho si el problema ocurre en una sola computadora, en todos los usuarios, en una sucursal o únicamente cuando varias personas trabajan al mismo tiempo.
Primero separa un bloqueo de una pérdida de conexión
Para el usuario ambos escenarios pueden sentirse iguales: SAE deja de responder y parece que el sistema “se cayó”. Sin embargo, las comprobaciones iniciales son diferentes.
Lo que observa el usuario
Qué conviene investigar primero
SAE deja de responder en una sola computadora y otros usuarios continúan trabajando
Estación, aplicación, conexión y configuración local
Varios usuarios pierden la conexión al mismo tiempo
Servidor, red, SQL Server, firewall o servicios compartidos
La conexión desaparece y después vuelve
Conectividad intermitente, red, firewall o servicios
El problema aparece únicamente en una sucursal
Comunicación entre ubicaciones, VPN y ruta de red
SAE deja de responder cuando trabajan varios usuarios
SQL Server, bloqueos, recursos y carga simultánea
Esta primera clasificación evita empezar por el servidor cuando la evidencia apunta a una sola estación o, al contrario, pasar por alto un componente compartido cuando varios usuarios tienen el mismo problema.
El alcance de la falla es la primera pista
Una de las comprobaciones más útiles consiste en preguntar quién más está afectado mientras ocurre el incidente.
Solo una computadora: compara esa estación con otra que funcione correctamente.
Varios equipos de la misma red: revisa los elementos que comparten.
Todos los usuarios: analiza servidor, SQL Server, red y servicios.
Una sola sucursal: concentra la investigación en la comunicación entre ubicaciones.
El problema aparece con varios usuarios: observa SQL Server y los recursos durante la operación simultánea.
Microsoft plantea aislar los problemas de conectividad de SQL Server revisando de manera progresiva el cliente, el servidor, la red, el firewall y la aplicación. Comparar qué equipos pueden conectarse y cuáles presentan la falla también ayuda a reducir el área de investigación.
Consulta la guía de Microsoft para diagnosticar problemas de conectividad de SQL Server.
Qué elementos propios de SAE debes revisar
En una instalación de Aspel SAE que trabaja en red hay componentes que merecen una revisión específica antes de atribuir el problema al hardware.
Aspel documenta el trabajo de SAE mediante un esquema cliente-servidor y contempla elementos como el Directorio de Archivos Comunes (DAC), el servidor de licencias y el monitoreo del servicio dentro del entorno de trabajo en red.
Consulta la documentación de Aspel sobre trabajo en red con SAE.
Separar estación, red, servidor, base de datos, archivos comunes y licencias ayuda a orientar el diagnóstico.
Directorio de Archivos Comunes
El DAC forma parte de la instalación de SAE en red y contiene las carpetas que el sistema utiliza para el trabajo compartido. Si el problema apareció después de mover el servidor, cambiar rutas, modificar permisos o alterar la red, conviene comprobar que las estaciones continúen accediendo correctamente a los recursos configurados.
Una estación que dejó de localizar correctamente los recursos compartidos puede presentar un comportamiento diferente al de las demás, aunque el servidor tenga capacidad suficiente.
Servidor de licencias
Cuando SAE trabaja con usuarios simultáneos, el servidor de licencias forma parte del entorno que debe funcionar correctamente. Las herramientas de monitoreo permiten comprobar el estado del servicio de licencias.
Por eso, si los problemas aparecen al iniciar sesión, al incorporar usuarios adicionales o durante el trabajo simultáneo, este componente debe formar parte de la revisión.
Seguridad y firewall
Una configuración incorrecta del firewall puede impedir que los clientes establezcan conexión con SQL Server. Por eso, cuando una estación no puede comunicarse con el servidor, conviene comprobar las reglas y los puertos utilizados por la instancia.
No es recomendable desactivar el firewall como solución permanente. La revisión debe centrarse en las reglas, puertos y servicios que corresponden a la instalación.
Si el problema está en la red, busca dónde se rompe la comunicación
La red gana importancia cuando el problema aparece únicamente en determinadas computadoras, horarios, segmentos o sucursales.
Una prueba de conectividad puede ayudar a determinar si la estación logra comunicarse con el servidor y con el puerto correspondiente. También conviene comparar el resultado con otra computadora que funcione correctamente.
¿La estación afectada puede comunicarse con el servidor?
¿Otras estaciones de la misma ubicación funcionan?
¿El problema aparece únicamente fuera de la oficina principal?
¿La conexión falla siempre o solamente durante determinados periodos?
¿Hubo cambios recientes en routers, firewall, VPN o direccionamiento?
La respuesta a estas preguntas ayuda a distinguir una falla localizada de un problema que afecta la ruta entre dos ubicaciones.
Cuando SQL Server interviene, observa qué estaba ocurriendo
Un bloqueo de SQL Server puede hacer que una operación tenga que esperar a que otra sesión libere un recurso. Los bloqueos forman parte del funcionamiento normal de una base de datos; el problema aparece cuando se mantienen durante demasiado tiempo y afectan el rendimiento o provocan tiempos de espera de la aplicación.
Consulta la documentación de Microsoft sobre bloqueos de SQL Server.
Esto resulta especialmente importante cuando SAE parece congelarse durante el trabajo simultáneo. En lugar de asumir que la computadora dejó de responder, conviene comprobar qué operación estaba ejecutándose y si otras sesiones estaban esperando.
También conviene observar el uso de CPU, memoria, almacenamiento, conexiones y otros recursos del servidor mientras ocurre la incidencia. La relación entre el recurso observado y el momento exacto del problema puede aportar una pista para continuar la investigación.
Una operación que mantiene ocupado un recurso puede hacer que otras sesiones tengan que esperar.
Haz una comparación antes de modificar la infraestructura
Una prueba sencilla consiste en ejecutar la misma operación desde dos estaciones que utilizan la misma instalación de SAE.
Elige una operación que los usuarios identifiquen claramente como problemática.
Realízala desde la computadora donde el bloqueo sea evidente.
Registra aproximadamente cuánto tarda o en qué momento deja de responder.
Repite exactamente la misma operación desde otra estación.
Comprueba si ambas utilizan los mismos recursos compartidos.
Observa el servidor durante ambas pruebas.
Compara qué cambia entre una estación y otra.
Si una computadora falla y otra funciona correctamente, la diferencia entre ambas estaciones se convierte en una pista. Si las dos presentan el mismo comportamiento, aumenta el interés por los componentes compartidos.
Ejecutar la misma operación desde dos estaciones permite detectar diferencias entre un equipo concreto y los componentes compartidos.
Usa el incidente como una prueba, no solo como una molestia
Cuando SAE vuelva a bloquearse o pierda la conexión, evita reiniciar inmediatamente todos los equipos. Primero recopila la información que pueda ayudar a reconstruir lo que estaba sucediendo.
Registra la hora exacta. Permite relacionar el incidente con eventos del servidor.
Anota qué operación estaba realizando el usuario. Una operación concreta puede ser reproducible.
Identifica a los usuarios afectados. Comprueba si el problema es individual o general.
Compara ubicaciones. Si existen sucursales, determina si todas presentan el mismo comportamiento.
Registra el mensaje de error. Una captura puede ser más útil que describirlo de memoria.
Observa el servidor. Revisa servicios y recursos mientras ocurre el problema.
Comprueba SQL Server. Si coincide con trabajo simultáneo, investiga esperas y bloqueos.
Registrar mensajes de error, horarios, usuarios afectados y condiciones del entorno permite comparar el incidente con el funcionamiento normal y acotar el origen de la falla.
Seguir las áreas de revisión de forma ordenada ayuda a aislar el origen de una pérdida de conexión en SAE.
Qué revisar según el patrón de la falla
Patrón observado
Área que gana prioridad
Qué comprobar
Solo una estación pierde conexión
Cliente y conexión local
Red, configuración, acceso a recursos y comportamiento de otras aplicaciones
Varias estaciones de la misma ubicación fallan
Red y recursos compartidos
Conectividad, firewall, rutas y acceso al servidor
Todos los usuarios pierden conexión
Servidor y servicios
SQL Server, servicios, red, firewall y recursos del servidor
Solo una sucursal presenta el problema
Comunicación entre ubicaciones
VPN, ruta de red, firewall y conectividad hacia el servidor
El bloqueo aparece con varios usuarios
SQL Server y recursos
Bloqueos, CPU, memoria, almacenamiento y carga simultánea
El bloqueo ocurre durante una operación concreta
Operación y base de datos
Repetibilidad, actividad de SQL Server y posibles esperas
Esta matriz no sustituye una revisión técnica. Su función es evitar que todas las incidencias terminen investigándose de la misma manera.
Cuándo el servidor sí entra en la investigación
La infraestructura debe ganar prioridad cuando el problema afecta a varios usuarios y durante el incidente existe evidencia de que algún recurso compartido está limitando la operación.
Por ejemplo, puede ser relevante observar:
CPU: si el procesamiento se mantiene elevado durante la incidencia.
Memoria: si existe presión de memoria o procesos que consumen una cantidad importante.
Almacenamiento: si las operaciones de entrada y salida presentan tiempos de respuesta elevados.
SQL Server: si coinciden esperas, bloqueos o actividad elevada con la operación afectada.
Red: si varias estaciones pierden comunicación simultáneamente.
Servicios: si el problema coincide con la detención o comportamiento anormal de un servicio necesario.
La clave es relacionar lo observado con el momento exacto de la incidencia. Un recurso elevado durante todo el día no necesariamente explica un bloqueo que aparece solamente bajo determinadas condiciones.
Cuándo cambiar el servidor no debería ser la primera medida
Hay situaciones en las que aumentar recursos no ataca directamente la causa observada.
Solo una estación presenta la falla.
El problema está limitado a una sucursal.
La comunicación se interrumpe por una configuración de red.
Una regla de firewall impide la conexión.
El servicio de licencias necesita revisión.
El DAC o los recursos compartidos no están accesibles correctamente.
Una operación concreta provoca esperas o bloqueos en SQL Server.
En estos escenarios, sustituir el servidor antes de investigar la causa puede dejar intacto el problema original.
Cuándo sí tiene sentido evaluar otra infraestructura
Una actualización puede tener sentido cuando la evidencia demuestra que la infraestructura actual está limitando de forma repetida la operación y que el problema está relacionado con un recurso compartido.
La decisión debe partir del diagnóstico. Si el almacenamiento es el elemento que limita, la evaluación será diferente de una situación en la que el procesamiento o la memoria son los recursos comprometidos.
El objetivo es que cualquier cambio de infraestructura tenga una razón técnica identificable y pueda comprobarse posteriormente si resolvió el problema.
Qué información debes reunir antes de pedir ayuda
Versión de Aspel SAE.
Mensaje o código de error.
Fecha y hora de la incidencia.
Usuarios afectados.
Estaciones afectadas.
Ubicación de los usuarios afectados.
Operación que estaban realizando.
Frecuencia del problema.
Si la falla es constante o intermitente.
Ubicación del servidor.
Configuración y versión de SQL Server.
Existencia de sucursales o VPN.
Cambios recientes en servidor, red o seguridad.
Ubicación y configuración del Directorio de Archivos Comunes.
Con esta información, una revisión técnica puede comenzar con datos concretos en lugar de partir de una suposición sobre el origen de la falla.
Si después del diagnóstico la infraestructura es el problema
Cuando la evidencia apunta al servidor o a otro componente de infraestructura, el siguiente paso debe ser evaluar qué cambio responde realmente a la necesidad encontrada.
En ese punto, Cobalt Blue Web puede ayudarte a revisar el entorno tecnológico utilizado por Aspel SAE y plantear una alternativa de infraestructura a partir de los datos obtenidos durante el diagnóstico.
La clave está en reproducir y aislar la falla
Cuando Aspel SAE se bloquea o pierde conexión, la pregunta útil no es solamente por qué “se cayó”. Lo importante es determinar qué usuarios están afectados, qué operación estaban realizando, qué componente compartido interviene y bajo qué condiciones aparece la incidencia.
Si el problema está limitado a una estación, la investigación comienza allí. Si afecta a una sucursal, la red gana prioridad. Si aparece con varios usuarios, hay que observar los componentes compartidos. Y si coincide con esperas o bloqueos, SQL Server debe formar parte del análisis.
Con esta información es posible pasar de reinicios repetitivos a un diagnóstico basado en evidencia y decidir después si hace falta corregir configuración, red, servicios, base de datos o infraestructura.
También puedes consultar más contenidos sobre servidores, ERP e infraestructura empresarial en el blog de ERP Nube México.